Jan Švec | honzas.cz
Menu

# Řečové technologie

11 položek

Všechny štítky

Adaptace modelů rozpoznávání řeči a kalibrace přesnosti pro archivy orální historie

24. září 2026

Rozsáhlé sbírky orální historie lze prohledávat, jakmile se řeč převede na časově zarovnaný text, badatelé však stále potřebují prakticky posoudit spolehlivost přepisu. Na DHECC 2026 v Odense jsem 24. září představil náš článek o adaptovaných modelech rozpoznávání řeči a kalibrovaných odhadech přesnosti pro šest jazyků, jehož spoluautory jsou Jan Lehečka a Pavel Ircing. Posluchači zde najdou prezentaci a přímé odkazy pro použití UWebASR v prohlížeči, přes BAS, s AI asistentem, pomocí API nebo na offline HPC infrastruktuře.
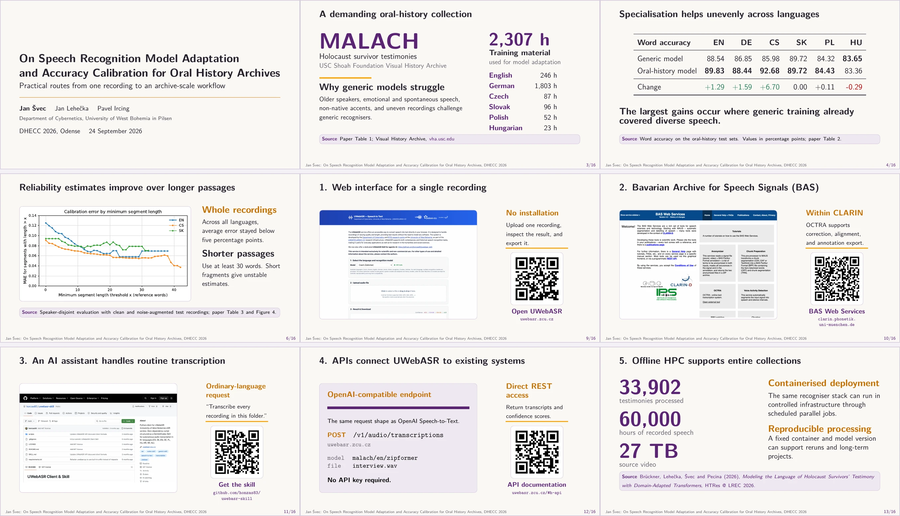
Náhled prezentace v devíti polích o rozpoznávání řeči a způsobech použití UWebASR pro archivy orální historie

Od tří promptů k jednomu: dva roky AI ve výuce

1. září 2026

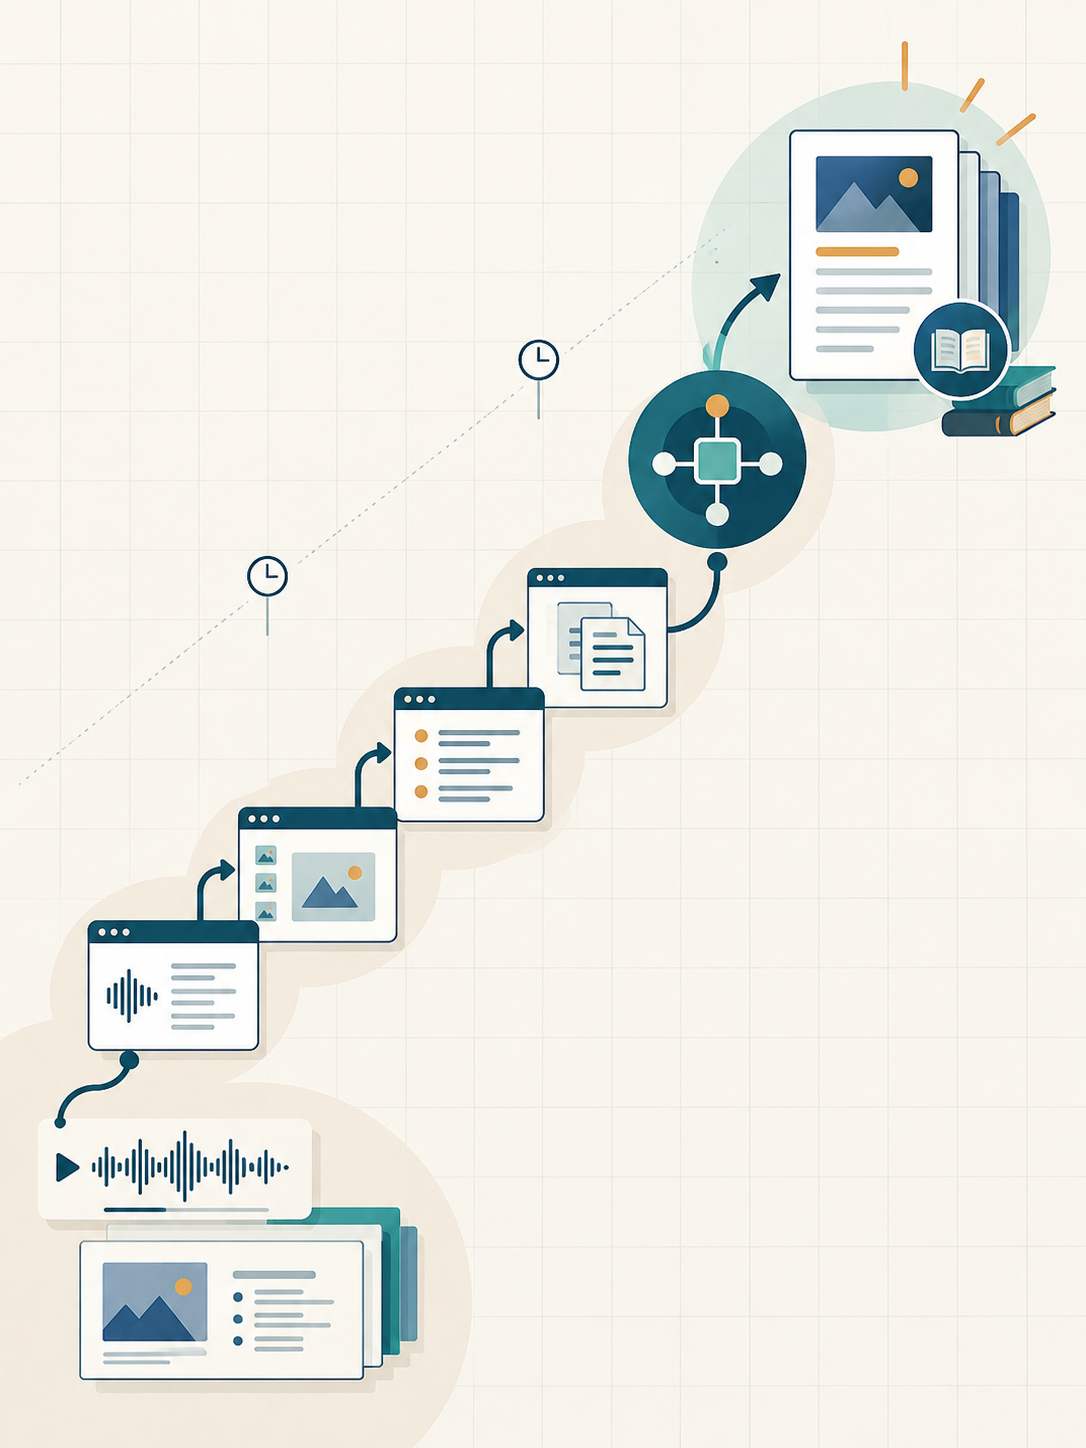
Příprava studijních materiálů z nahrané přednášky je typickým příkladem práce, kterou generativní AI během krátké doby zásadně zjednodušila. Před dvěma lety jsem ručně přenášel nahrávku, přepis, slajdy a tři základní prompty mezi samostatnými nástroji. Dnes stačí k nahrávce a slajdům jediný pokyn, po kterém vznikne zkontrolované shrnutí, obsah nad rámec prezentace, slovníček a hotové PDF pro studenty.

Portrétní ilustrace vývoje od nahrávky a slajdů k automaticky vytvořenému studijnímu materiálu

Nezapomenutelný den paměti na Vinohradech s DigiDiaDem

18. června 2026

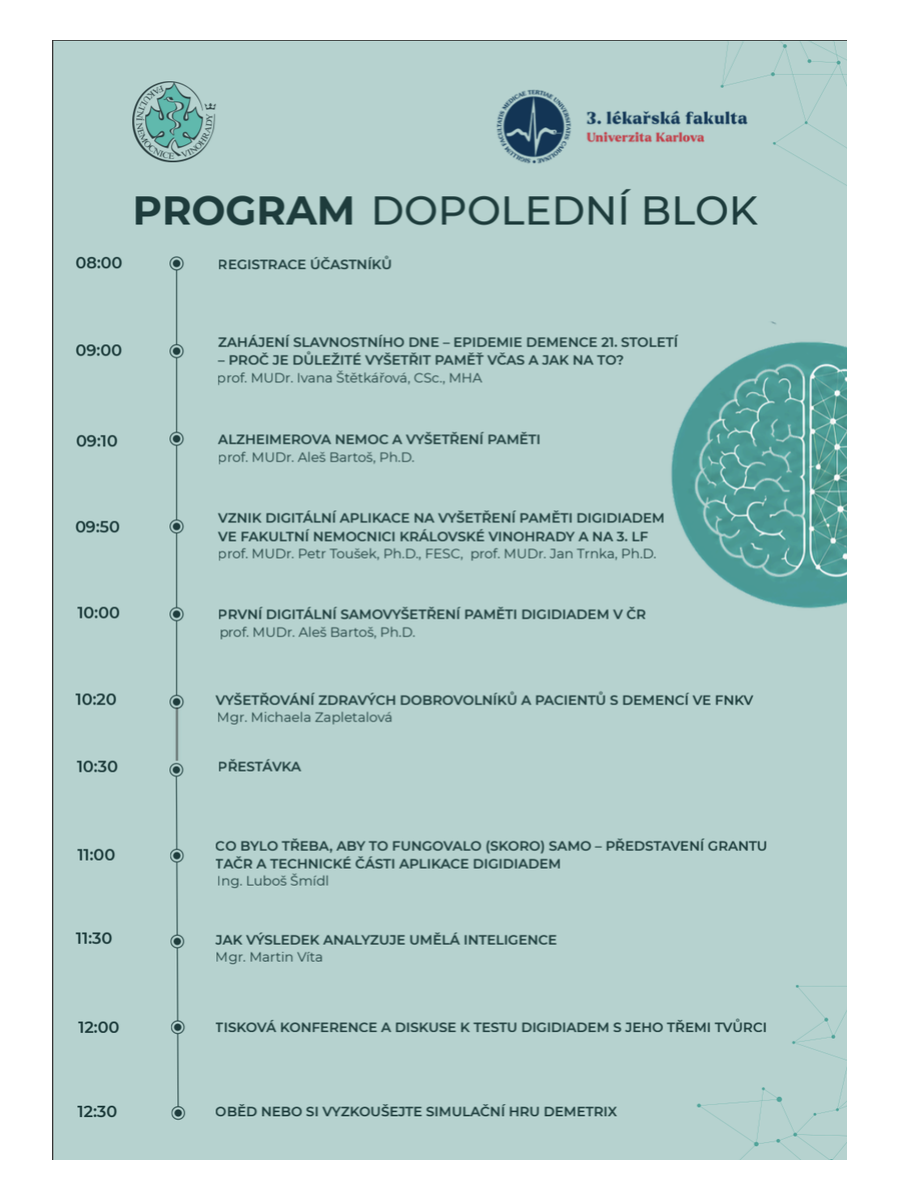
Obava o paměť může odstartovat dlouhé hledání někoho, kdo propojí jednotlivá vyšetření a doporučí správný další krok. Na Nezapomenutelném dni paměti na Vinohradech jsme s týmem DigiDiaDem na anonymizovaném příběhu připomínajícím pohádku o slepičce a kohoutkovi ukázali, jak roztříštěná tato cesta někdy bývá. Případ zároveň ukázal, jak může krátký digitální prescreening doplnit standardní vyšetření, aniž by nahrazoval klinickou diagnózu.

Dopolední program Nezapomenutelného dne paměti na Vinohradech s časovým rozvrhem

Řečově-kognitivní dataset DigiDiaDem: první experimenty s detekcí kognitivních poruch z řeči

6. února 2026

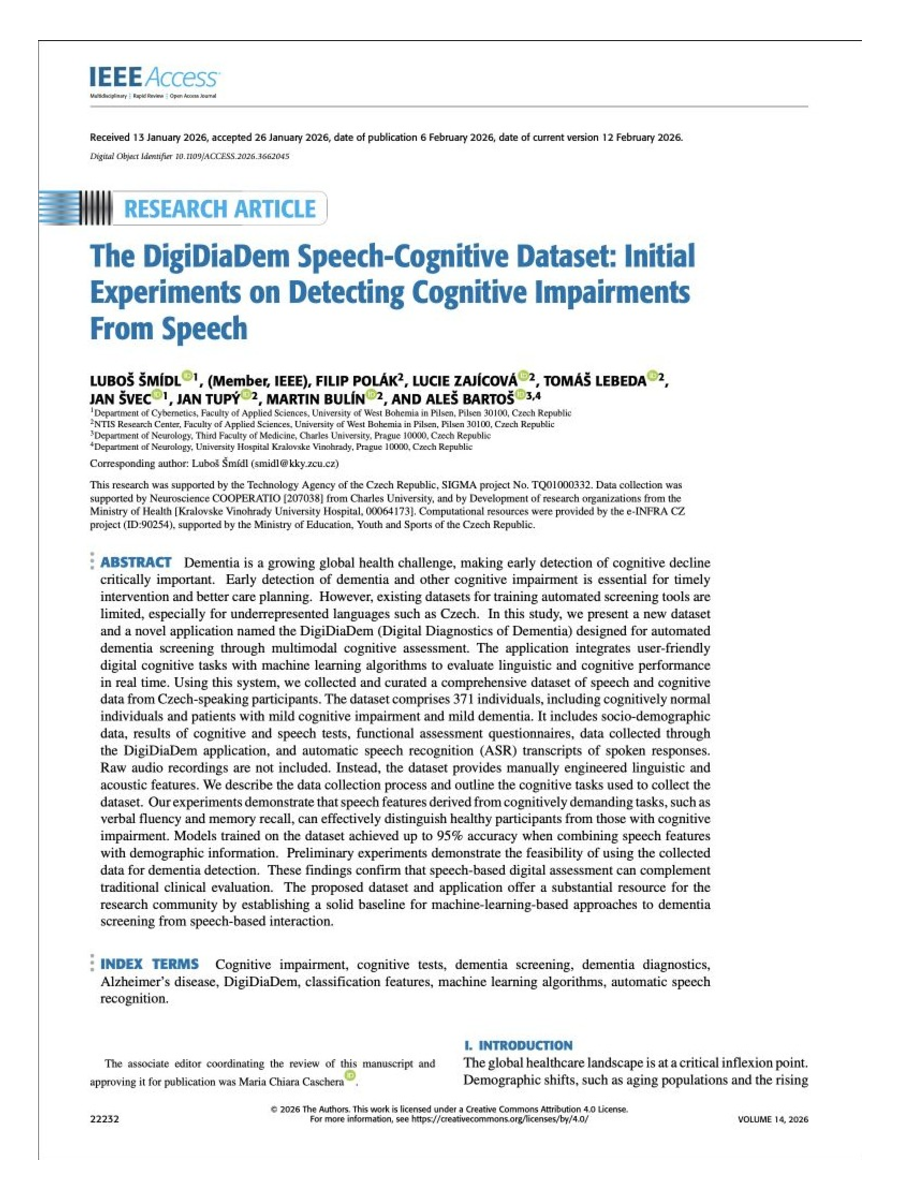
Výzkum kognitivních poruch z řeči potřebuje data, která propojí dobře navržené úlohy, klinický kontext a reprodukovatelné vyhodnocení. Náš článek v IEEE Access představuje řečově-kognitivní dataset DigiDiaDem a první experimenty, které nad ním vznikly. Práce spojuje návrh dialogového systému, rozpoznávání řeči, přípravu dat a vyhodnocení metodami strojového učení.

Portrétní náhled první strany článku o datasetu DigiDiaDem

Mentoring na 10. ročníku AimtecHackathonu

2026

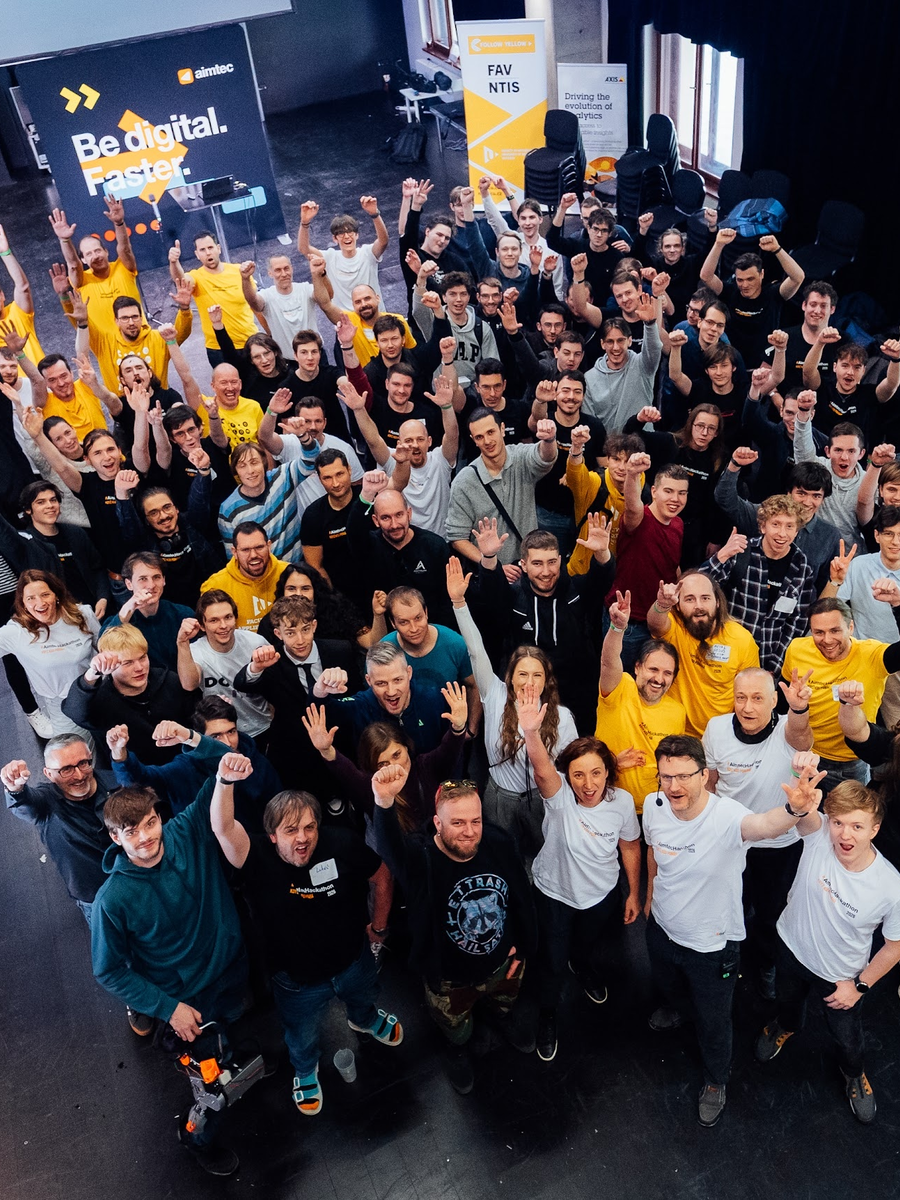
Hackathony dávají týmům soustředěný prostor proměnit nápady ve funkční prototypy s podporou zkušených mentorů. Na 10. ročníku AimtecHackathonu v roce 2026 jsem znovu mentoroval týmy, které pracovaly s AI, LLMs, lokálními modely, rozpoznáváním a syntézou řeči, jazykovými technologiemi a Pythonem. Víkend zároveň ukázal, kolik soustavné práce věnují Petra Šteklová, Jiří Dobrý a celý tým Aimtecu podpoře plzeňské hackerské komunity.

Portrétní fotografie z AimtecHackathonu 2026 zachycující týmy při práci ve chvíli, kdy časomíra dosáhla nuly

Výuka v režii AI: Co funguje a kde jsou limity?

1. září 2025

Generativní AI může z přednášky připravit studijní oporu, pomoci studentům s procvičováním a nabídnout vyučujícímu další pohled na vlastní materiály. Na AI Monday Plzeň #7 jsem 1. září 2025 ukázal svůj postup od nahrávky přes přepis v UWebASR po chronologické shrnutí, témata diskutovaná nad rámec slajdů, slovníček a experimentální Custom GPT. Součástí přednášky byly také praktické limity: kvalita vstupu, lidská kontrola, ochrana soukromí a omezená zpětná vazba o používání chatbota.

Portrétní náhled titulního slajdu přednášky o AI ve vysokoškolské výuce

Detekce kognitivních poruch pomocí opakování nesmyslných slov založeného na ASR

22. srpna 2025

Krátké řečové úlohy mohou zachytit kognitivní změny bez dlouhého klinického rozhovoru. Článek zkoumá, zda lze pomocí automatického rozpoznávání řeči vyhodnotit okamžité opakování nesmyslných slov a rozlišit zdravé účastníky od osob s kognitivní poruchou. Experiment ukazuje, proč při zapojení řečových technologií do screeningu záleží na chybách rozpoznávání, fonologické podobnosti i volbě jazykového modelu.

Portrétní náhled článku o opakování nesmyslných slov

Automatická detekce kognitivních poruch pomocí sémantické analýzy slovních popisů obrázků

22. srpna 2025

Slovní popis obrázku vypovídá nejen o výslovnosti, ale také o tom, kterých pojmů a vztahů si člověk všímá a jak je uspořádá v jazyce. Článek kombinuje rozpoznávání řeči, formální sémantickou analýzu a strojové učení při porovnávání českých popisů s expertní referencí. Výsledné sémantické příznaky nabízejí interpretovatelnou cestu ke škálovatelnému screeningu kognitivních poruch.

Portrétní náhled článku o sémantické analýze popisů obrázků

Řečové technologie: od výzkumu k praxi

12. června 2015

V rámci Machine Learning Meat-Ups jsme s kolegou Jindrou Matouškem mluvili o řečových technologiích v praxy. Kdo 1.4. nestihl přednášku s podtitulem od výzkumu k praxi se může podívat na videu níže. V prezentaci představíme jednotlivá výzkumná témata z oblasti řečových technologií, jimiž se na našem pracovišti zabýváme, zejména počítačovou syntézu (TTS) a rozpoznávání (ASR) řeči.