Rozsáhlé sbírky orální historie lze prohledávat, jakmile se řeč převede na časově zarovnaný text, badatelé však stále potřebují prakticky posoudit spolehlivost přepisu. Na DHECC 2026 v Odense jsem 24. září představil náš článek o adaptovaných modelech rozpoznávání řeči a kalibrovaných odhadech přesnosti pro šest jazyků, jehož spoluautory jsou Jan Lehečka a Pavel Ircing. Posluchači zde najdou prezentaci a přímé odkazy pro použití UWebASR v prohlížeči, přes BAS, s AI asistentem, pomocí API nebo na offline HPC infrastruktuře.
První blok příspěvků na DHECC 2026 spojil čtyři přístupy k výpočetní analýze dědictví konfliktů. V DIAS Auditorium na University of Southern Denmark jsem představil naši práci na rozpoznávání řeči pro archivy orální historie; spoluautory článku jsou Jan Lehečka a Pavel Ircing.
Přednáška vycházela z našeho nedávno publikovaného článku v International Journal of Digital Humanities. Od výsledků výzkumu rychle přešla k praktické otázce: jak může badatel, vývojář nebo archiv rozpoznávač skutečně použít?
Od přepisu k odhadu spolehlivosti
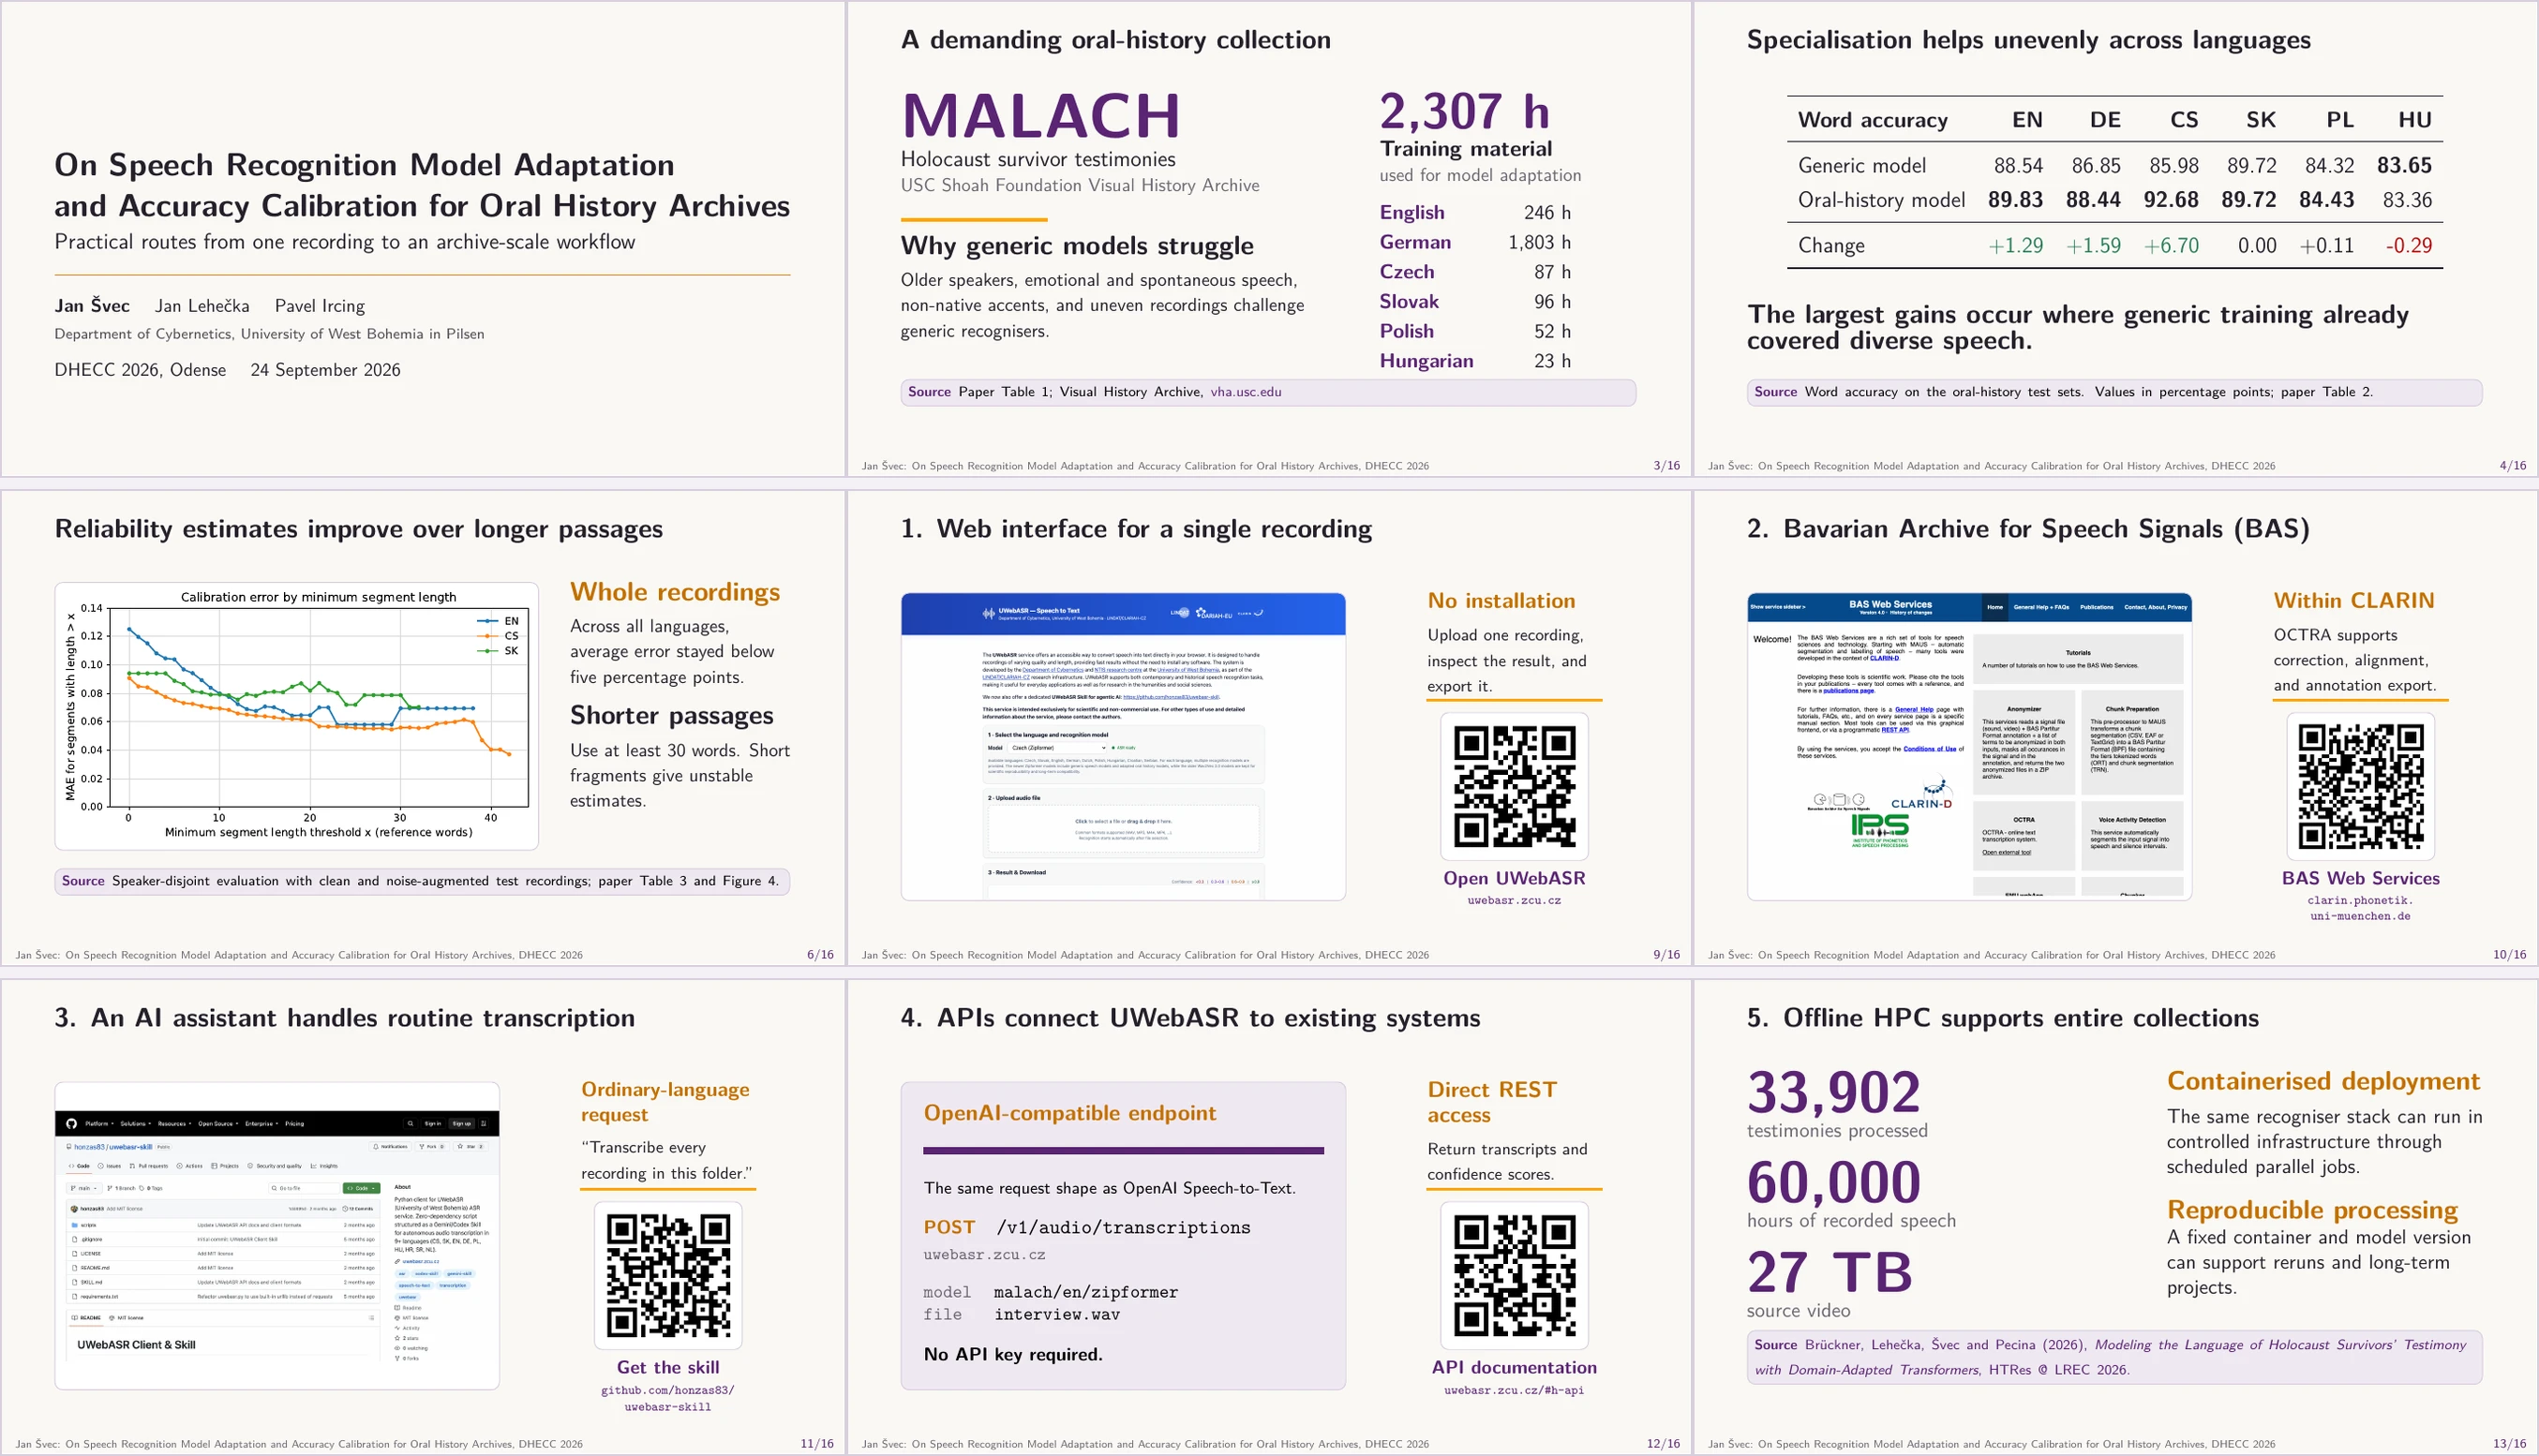
Modely jsme adaptovali na svědectví přeživších Holocaustu v angličtině, němčině, češtině, slovenštině, polštině a maďarštině. Adaptace přinesla v jednotlivých jazycích rozdílné zlepšení, nejvíce v češtině. I tento rozdíl je důležitý výsledek, protože kvalita a rozmanitost obecných tréninkových dat ovlivňuje výsledek stejně jako dostupnost oborově specifických dat.
UWebASR umí k přepisu přidat také odhad očekávané slovní přesnosti pro konkrétní model. Na úrovni celých nahrávek zůstala v našem vyhodnocení průměrná chyba kalibrace pod pěti procentními body ve všech šesti jazycích. Krátké fragmenty jsou méně stabilní, proto je stále potřeba ověřovat důležitá jména, místa a citace poslechem nahrávky.
Pět způsobů použití UWebASR
Druhá polovina přednášky ukázala pět způsobů, jak UWebASR použít k přepisu nahrávek. Vhodná volba závisí na velikosti sbírky, navazujícím workflow a pravidlech pro práci s daty, která určil správce konkrétní sbírky.
- Webové rozhraní - v prohlížeči nahrajete jednu nahrávku, prohlédnete si confidence informace a odhad přesnosti a přepis vyexportujete v několika formátech.
- BAS Web Services - UWebASR lze použít v zavedeném prostředí CLARIN s nástroji pro zarovnání, korekturu a export anotací.
- AI asistent - zadáte běžným jazykem například „přepiš všechny nahrávky v této složce“ a veřejný UWebASR skill obstará rutinní kroky.
- HTTP API a rozhraní kompatibilní s OpenAI - rozpoznávač zapojíte do existující aplikace a získáte přepis spolu s confidence informacemi. Endpoint kompatibilní s OpenAI používá známý formát požadavku
/v1/audio/transcriptionsa nepotřebuje API klíč. - Offline zpracování na HPC - stejný rozpoznávač lze provozovat v infrastruktuře pod kontrolou správce sbírky. Pro reprodukovatelné paralelní zpracování na HPC máme připravený Singularity/Docker image, který podporuje také rozsáhlé nebo omezeně přístupné sbírky.
Veřejná služba UWebASR zpracovává nahrávku a výsledky rozpoznávání po dobu relace na infrastruktuře Západočeské univerzity. Po skončení relace nahrané audio ani vytvořený přepis neuchovává. Omezeně přístupné sbírky mohou vyžadovat offline zpracování pod kontrolou jejich správce; rozhodující jsou pravidla konkrétní sbírky.
Prezentace a článek
Kompletní prezentace obsahuje výsledky, QR kódy i přímé odkazy použité během přednášky. Článek je dostupný přes DOI záznam a jako plný text na SharedIt. Dřívější článek o kalibraci popisuje cestu metody od proof of concept do produkčního provozu.
Odkazy
- Prezentace: Kompletní PDF prezentace použité na DHECC 2026 dne 24. září 2026.
- Publikovaný článek: Recenzovaný článek v International Journal of Digital Humanities, ze kterého přednáška vychází.
- Plný text na SharedIt: Přístup SharedIt od vydavatele k plnému textu článku.
- Program DHECC 2026: Dvoudenní program konference včetně sekce Computational Analysis of Conflict Heritage.
- Webové rozhraní UWebASR: Přístup z prohlížeče pro nahrání jednoho záznamu, kontrolu přepisu a export výsledku.
- BAS Web Services: Nástroje propojené s CLARIN pro zarovnání, korekturu a export anotací.
- UWebASR Client & Skill: Veřejný agentní skill a klient v Pythonu pro přepis souborů a složek pomocí UWebASR.
- Dokumentace API UWebASR: HTTP API a rozhraní kompatibilní s OpenAI pro zapojení přepisu do existujících systémů.
- Offline nasazení na HPC: Článek z HTRes 2026 o zpracování 33 902 svědectví v kontrolované infrastruktuře.
- Od UWebASR k odhadu přesnosti rozpoznávání: Praktický popis kalibračního workflow a jeho nasazení v UWebASR.