Ve skenovaných archivních sbírkách se obtížně hledá, pokud chybí plný text a jednotná metadata. Příspěvek na workshopu CLARIN, DARIAH & Libraries 2026 ukázal, jak v týmu pomocí velkých jazykových modelů přepisujeme a obohacujeme archivní dokumenty NATO. Představili jsme cestu od původního skenu k propojeným výzkumným materiálům včetně zkušeností badatelů a limitů generovaných popisů.
Od skenu k badatelskému čtení
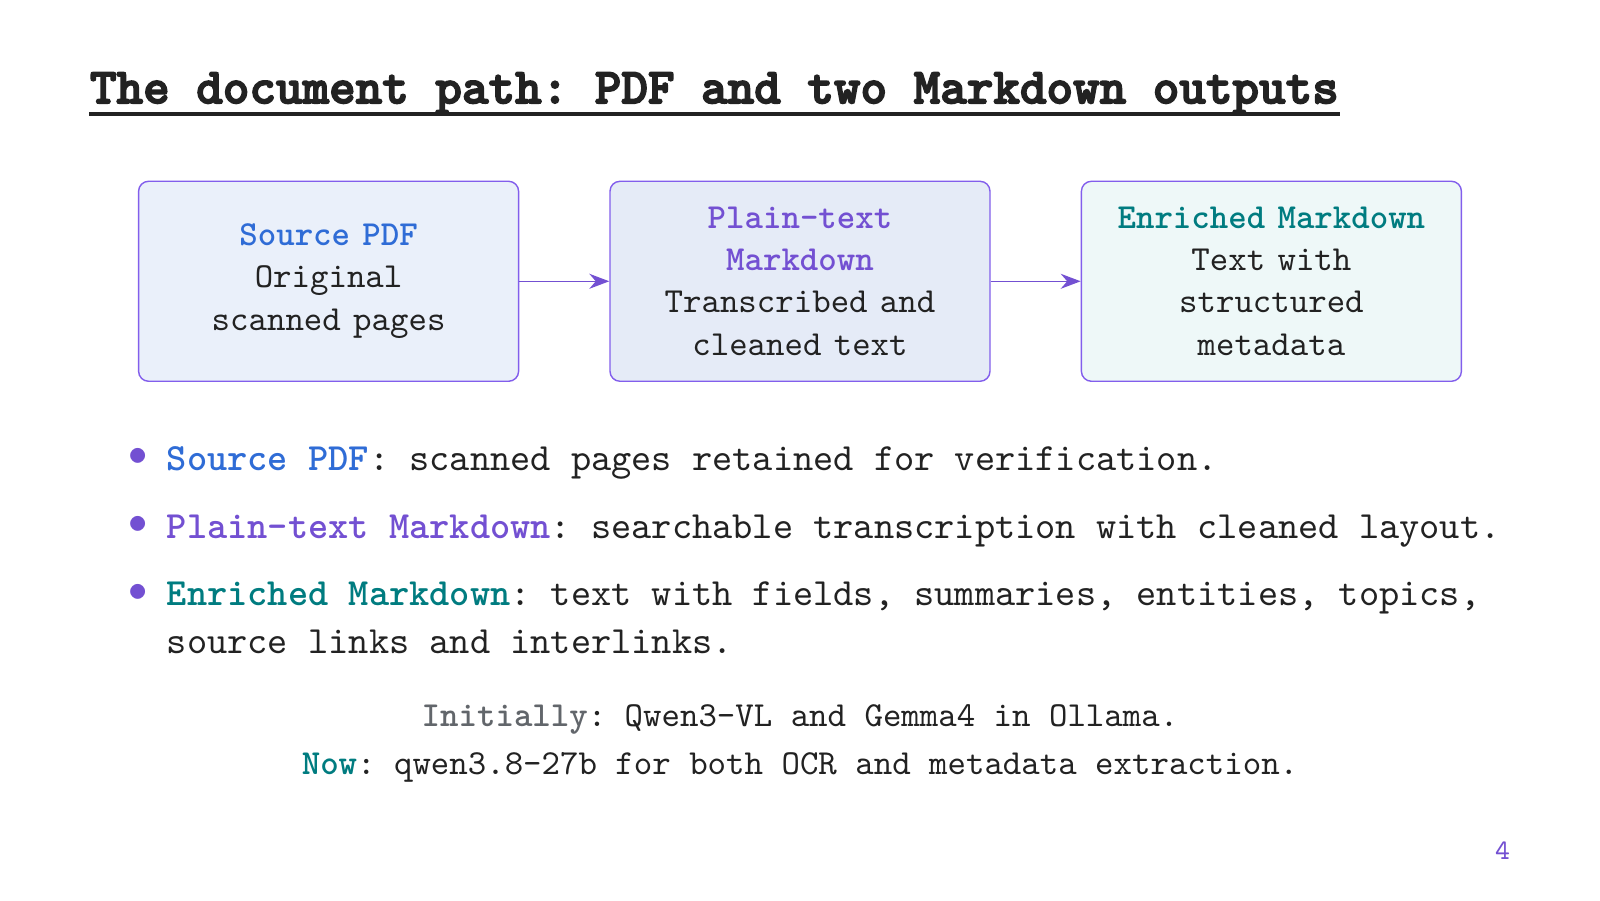
Sbírka zahrnuje odtajněné a veřejně dostupné anglické a francouzské dokumenty z NATO Archives a knihovny NATO v Bruselu. V prezentaci jsme sledovali dokument od přepisu přes čištění textu až po získávání metadat. Výsledkem je prohledávatelný text doplněný názvem, datem, shrnutím, tématy, entitami a odkazy na související záznamy, přičemž původní sken zůstává dostupný pro kontrolu.
Na získávání metadat pracujeme ve třech: já z Fakulty aplikovaných věd Západočeské univerzity v Plzni, Lauren Sukin z Department of Politics and International Relations a Nuffield College na Oxfordské univerzitě a Michal Smetana z Fakulty sociálních věd Univerzity Karlovy, který působí také jako Visiting Fellow na All Souls College v Oxfordu. Během mého výzkumného pobytu v Oxfordu jsme společně rozvíjeli a ověřovali tento postup.
Ukázali jsme také, jak mohou badatelé dokumenty vyhledávat, sledovat jejich vzájemné odkazy a vybrané texty shromáždit pro další práci v Obsidianu. Jde o aplikaci pro práci s lokálně uloženými textovými poznámkami a jejich vzájemné propojování. Zpracované dokumenty v ní mohou badatelé číst, doplňovat vlastními poznámkami a sledovat souvislosti mezi prameny.
Jako společný datový formát používáme Markdown, tedy prostý text s jednoduchým zápisem struktury dokumentu. Je kompatibilní s Obsidianem a zároveň oblíbený pro další zpracování v agentní AI. Stejné soubory tak můžeme používat pro badatelské čtení i jako vstup pro AI agenty.
Co je potřeba kontrolovat
Součástí příspěvku byla zpětná vazba badatelů a kontrola zpracovaných dokumentů. Generovaná shrnutí mohou pomoci s výběrem materiálů, ale také vynechat přílohy nebo přecenit, co dokument skutečně říká. Chyby OCR se mohou přenést do dat a odkazů, proto zachováváme přístup k původnímu PDF.
Představili jsme také Archivatorium, sadu nástrojů, kterou vyvíjíme s AI agenty na základě slovně formulovaných specifikací. Pomocí velkých jazykových modelů zajišťujeme přepis, čištění textu i získávání metadat; z vytěžených odkazů pak propojujeme související dokumenty.
Prezentace a workshop
Příspěvek Use of LLMs for metadata extraction from NATO archive documents jsme připravili pro workshop CLARIN, DARIAH & Libraries 2026 v Národní knihovně ČR v pražském Klementinu. Workshop se věnoval zpřístupňování knihovních sbírek pro digitální humanitní vědy a jazykový výzkum. Slajdy jsou ke stažení v PDF.
Odkazy
- Prezentace v PDF: Úplná prezentace se 13 snímky, ukázkami dokumentů a zpětnou vazbou badatelů.
- Workshop a program: Oficiální stránka s programem, místem konání a pořadateli workshopu.
- Archivatorium: Zdrojový kód a dokumentace nástrojů pro zpracování dokumentů.
- NATO Archives: Archivní katalog NATO se zdrojovými dokumenty.
- Lauren Sukin: Associate Professor of US Foreign Policy na Oxfordské univerzitě a Professorial Fellow v Nuffield College.
- Michal Smetana: Docent mezinárodních studií na Univerzitě Karlově a Visiting Fellow na All Souls College v Oxfordu.
- Obsidian: Aplikace pro lokální textové poznámky a jejich propojování.